Die Berechnung von SHAP-Werten kann rechenintensiv sein, selbst mit effizienten Algorithmen wie TreeSHAP. Unser aktueller TreeSHAP-Algorithmus skaliert linear mit der Anzahl der Beobachtungen, Bäume und Blätter und quadratisch mit der Tiefe der Bäume.
Obwohl TreeSHAP im Vergleich zu anderen Explainern wie SamplingExplainer schnell ist, kann die Berechnung bei vielen Beobachtungen trotzdem langsam werden. GPUTreeExplainer gibt es bereits seit 2020, doch bisher mussten Nutzerinnen und Nutzer ihn selbst aus dem Quellcode bauen. Dies ist einer der Kritikpunkte aus dem Mindful-Modeler-Blogbeitrag über die Arbeit an SHAP.
Wir freuen uns sehr, die Veröffentlichung von shap-cuda auf PyPI bekannt zu geben. Das Paket beschleunigt Erklärungen für Baummodelle mit GPUTreeExplainer auf realistischen Workloads um das 90–180-Fache.
Was bedeutet das für Nutzerinnen und Nutzer?
Ihr könnt Baummodelle jetzt etwa 100× schneller erklären als bisher, selbst auf kleineren GPUs. Das bereitgestellte Binary erspart euch die eigene Kompilierung des GPU-Backends und erleichtert den Einstieg in GPU-beschleunigte Erklärungen erheblich.
Die Installation erfolgt mit:
pip install 'shap[cuda]'Dieses Beispiel trainiert einen Random Forest mit dem mitgelieferten Diabetes-Datensatz von SHAP und erklärt die zurückgehaltenen Beobachtungen mit GPUTreeExplainer. Führt es auf einer CUDA-fähigen GPU aus:
# prerequisites: pip install 'shap[cuda]' scikit-learn

import shap
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split

# Einen mitgelieferten Beispieldatensatz laden (kein Download nötig).
X, y = shap.datasets.diabetes()
X_train, X_test, y_train, _ = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Ein kleines Baummodell auf der CPU trainieren.
model = RandomForestRegressor(
    n_estimators=100, max_depth=6, random_state=42
).fit(X_train, y_train)

# SHAP-Werte für zurückgehaltene Beobachtungen auf der GPU berechnen.
explainer = shap.GPUTreeExplainer(
    model, feature_perturbation="tree_path_dependent"
)
shap_values = explainer.shap_values(X_test)
print(shap_values.shape)  # (89, 10)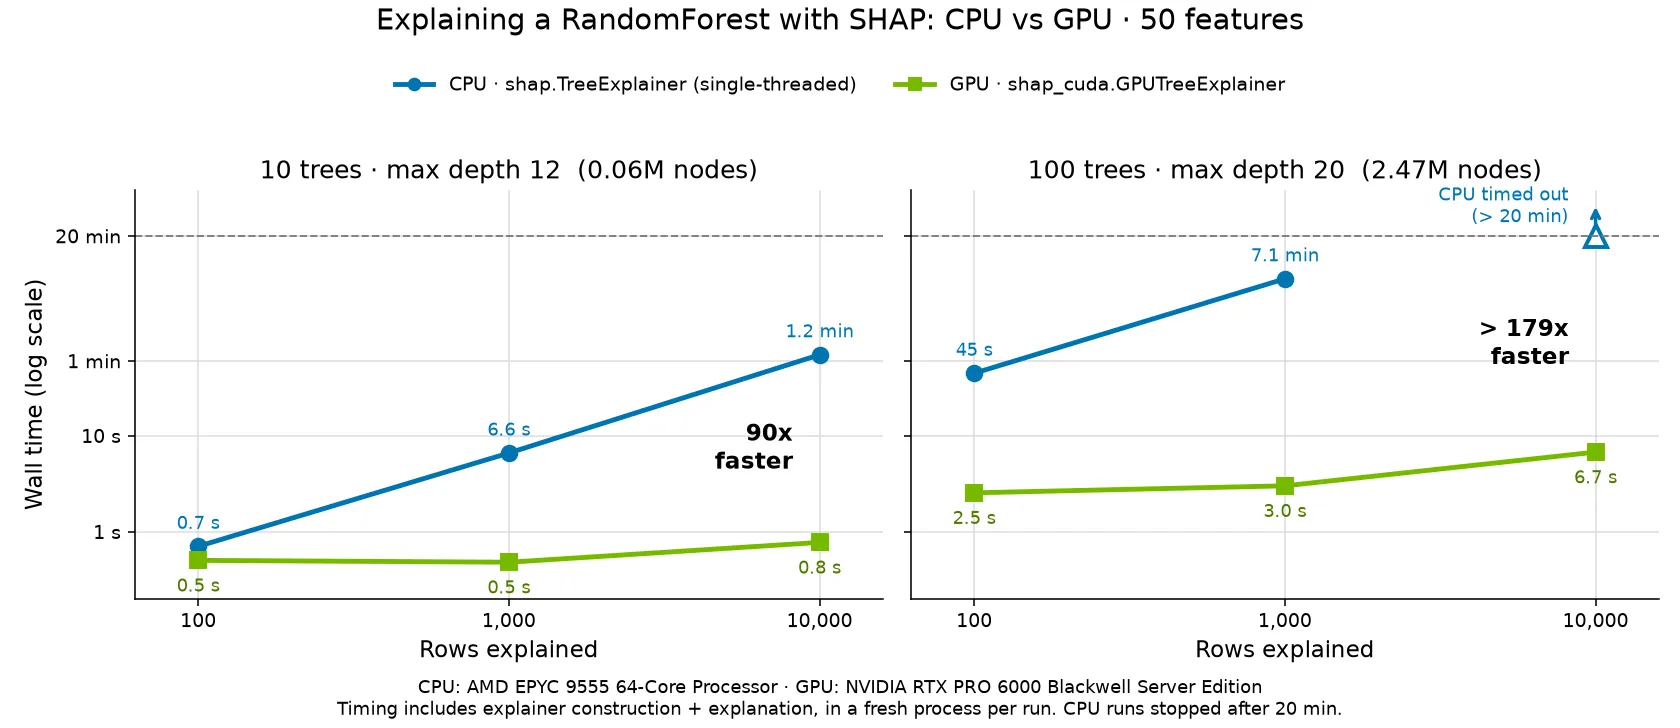
Berechnungszeit über die Anzahl der Zeilen: TreeExplainer mit einem CPU-Thread auf einem AMD EPYC 9555 im Vergleich zu GPUTreeExplainer auf einer NVIDIA RTX PRO 6000 Blackwell Server Edition. Die Zeit umfasst die Erstellung des Explainers und die Berechnung der Erklärungen; CPU-Läufe wurden nach 20 Minuten abgebrochen.
Stellt euch vor, ein zweistündiger Job ist in einer Minute erledigt — dank der enormen Parallelisierung durch CUDA.
Wie wir das umgesetzt haben
Wir haben die CUDA-Implementierung in das separate, optionale Paket shap-cuda im Verzeichnis backends/ des Repositorys ausgelagert. Dadurch können wir das GPU-Backend unabhängig vom SHAP-Kernpaket bauen und bereitstellen. Wer GPU-Beschleunigung nutzen möchte, installiert es mit pip install 'shap[cuda]'; die Standardinstallation hängt nicht vom CUDA-Backend ab.
Um beide Pakete zu verbinden, nutzen wir Entry Points des Python-Paketsystems. Das CUDA-Paket registriert seinen Explainer in der Gruppe shap.tree_backends. SHAP erkennt und lädt ihn, sobald Nutzerinnen und Nutzer auf shap.GPUTreeExplainer zugreifen. So bleibt die vertraute API erhalten. Gleichzeitig können sich künftig weitere Beschleuniger-Backends über denselben Mechanismus einbinden, ohne dass Nutzerinnen und Nutzer ein Backend-spezifisches Paket importieren müssen.
Außerdem haben wir GPU-Tests auf AWS eingerichtet, die bei Bedarf laufen. Der Workflow startet eine EC2-Instanz mit GPU, checkt das Repository aus, baut SHAP und das CUDA-Backend und führt die GPU-bezogenen Tests aus.
Ein Cleanup-Job beendet die Instanz auch dann, wenn Tests fehlschlagen. Die Testdatensätze werden vorher auf einem CPU-Runner heruntergeladen, damit der GPU-Runner seine Zeit mit Tests statt mit Downloads verbringt.
Unser Release-Workflow ist darauf ausgelegt, genau das Wheel zu testen, das veröffentlicht werden soll. Die CUDA-Kompilierung läuft auf einem CPU-Runner mit CUDA-Toolkit; eine physische GPU wird erst zur Ausführung der Tests benötigt. Das gebaute Wheel wird an den AWS-GPU-Runner übergeben, und die Veröffentlichung setzt erfolgreiche Tests voraus. Damit prüfen wir das Binary, das Nutzerinnen und Nutzer installieren werden, statt für die Tests eine andere Kopie neu zu bauen.
Wir haben verschiedene Optionen evaluiert und uns angesehen, wie scikit-learn GPU-Tests umgesetzt hat.
Wie scikit-learn führen wir GPU-Tests gezielt aus, wenn Maintainer das Label CUDA CI setzen. Um die Rechenkosten zu senken, haben wir uns für AWS-Runner entschieden, die bei Bedarf starten. Die Bereitstellung und das Aufräumen übernehmen wir selbst.
Bei T4-GPUs ist AWS bei den reinen Rechenkosten ungefähr 5× günstiger: Für eine Linux-Instanz vom Typ g4dn.xlarge in US East (Nord-Virginia) werden etwa 0,526 US-Dollar pro Stunde angegeben, gegenüber 3,12 US-Dollar pro Stunde für den Linux-GPU-Runner von GitHub. Start- und Einrichtungszeit, Speicher und Netzwerk verursachen zusätzliche AWS-Kosten. Insgesamt erwarten wir aber weiterhin, dass AWS um ein Mehrfaches günstiger ist.
Vielen Dank
Ein besonderer Dank geht an unsere Open-Source-Heimat, das German Center for Open Source AI, das die fiskalische Trägerschaft für die GPU-Runner übernimmt, und an das NVIDIA-Team, das die Finanzierung bereitstellt und uns bei der technischen Umsetzung unterstützt.